
AI-Coding Enablement im Team einführen: Governance, Repository-Regeln und TDD statt Lizenzverteilung
AI-Coding Enablement verankert generative Entwickler-Tools (wie GitHub Copilot, Cursor oder Claude Code) nicht als isolierte Lizenzen, sondern als diszipliniertes 4-Schichten-Modell im Team: Klare Governance für Quellcode-Schutz, versionierter Repository-Kontext (AGENTS.md), Test-Driven Development (TDD) als deterministisches Abbruchkriterium und strenge CI/CD-Gates mit Obergrenzen für Pull-Request-Größen (200–300 Zeilen). So wird die gewonnene Tippgeschwindigkeit in messbare, qualitätsgesicherte Auslieferungsstabilität übersetzt.Die Lizenzen sind beschafft, das Team hat Zugriff auf GitHub Copilot, Cursor oder Claude Code. Drei Monate später zeigt sich in vielen Software-Organisationen dasselbe Bild: Einzelne Entwickler tippen spürbar schneller, das Gesamtteam liefert jedoch nicht merklich mehr fertige Features aus. Stattdessen wachsen die Pull-Request-Warteschlangen, der Review-Aufwand explodiert, und die Unsicherheit bezüglich Datenschutz, IP-Rechten und Codequalität nimmt zu.
Dieser Fachartikel analysiert die strukturellen Ursachen dieses Phänomens und stellt ein praxiserprobtes 4-Schichten-Betriebsmodell vor, mit dem Entwicklungsteams KI-Coding steuerbar, sicher und nachhaltig produktiv verankern.
Das Problem: Schneller tippen ist nicht schneller liefern
Es existieren fundierte empirische Belege, dass KI-Assistenten isolierte Aufgaben signifikant beschleunigen. In einem kontrollierten Experiment von Peng et al. (2023) implementierten Entwickler eine klar umrissene Programmieraufgabe – das Schreiben eines HTTP-Servers in JavaScript – mit GitHub Copilot um 55,8 Prozent schneller als die Kontrollgruppe ohne KI-Unterstützung. Die Autoren betonen jedoch ausdrücklich den Laborcharakter dieser standardisierten Aufgabe. Wie viel dieser Beschleunigung im realen Projektalltag mit gewachsenen Legacy-Architekturen ankommt, lässt sich daraus nicht unmittelbar ableiten. Quelle: arXiv:2302.06590.
Gleichzeitig belegen aktuelle Industrieanalysen erhebliche Risiken für die langfristige Softwarequalität:
- GitClear-Langzeitanalysen: GitClear untersuchte die Evolution von Codequalität anhand hunderter Millionen veränderter Codezeilen. Im Forschungsbericht von 2024 (Basis: ca. 153 Millionen geänderte Zeilen von Januar 2020 bis Dezember 2023) verdoppelte sich der Anteil an Code Churn (Code, der innerhalb von weniger als zwei Wochen erneut revidiert oder gelöscht wird) gegenüber dem Niveau von 2021 nahezu. Im Folge-Update von 2025 (Basis: 211 Millionen Zeilen bis Ende 2024) fiel der Anteil an refaktoriertem (verschobenem) Code auf unter 10 % (gegenüber 25 % im Jahr 2021), während der Anteil an kopierten Codezeilen von 8,3 % auf 12,3 % stieg. Als Anbieter von Code-Analyse-Werkzeugen verfolgt GitClear kommerzielle Interessen, und die Daten spiegeln statistische Korrelationen wider – sie liefern jedoch ein ernstzunehmendes Warnsignal für wachsende technische Schulden. Quellen: GitClear 2024 Research und GitClear 2025 Research.
- DORA-Report 2024: Die DevOps Research and Assessment Initiative (DORA) von Google Cloud identifizierte einen statistischen Zusammenhang zwischen intensiverer KI-Nutzung und einer messbar geringeren Stabilität der Auslieferung (-7,2 % Delivery Stability und -1,5 % Throughput pro 25 % Anstieg der KI-Adaption). DORA präsentiert größere Änderungsmengen (Batch Sizes) als wahrscheinlichen Erklärungsansatz: Wenn Entwickler mehr Code in kürzerer Zeit generieren, dieser aber in zu großen Pull Requests ohne adäquate automatisierte Test- und Review-Praktiken landet, sinkt die Stabilität des Gesamtsystems. Quelle: DORA 2024 Report.
Fazit: KI senkt die Grenzkosten der Codeerzeugung drastisch. Sie senkt jedoch nicht die Kosten, Code zu verstehen, zu prüfen, architektonisch einzuordnen und dauerhaft zu warten. Wenn sich der Engpass vom Schreiben zum Review verschiebt, bleibt der Gesamtdurchsatz unverändert – es sei denn, die Prüfprozesse werden synchron professionalisiert.
Das 4-Schichten-Modell für produktives AI-Coding
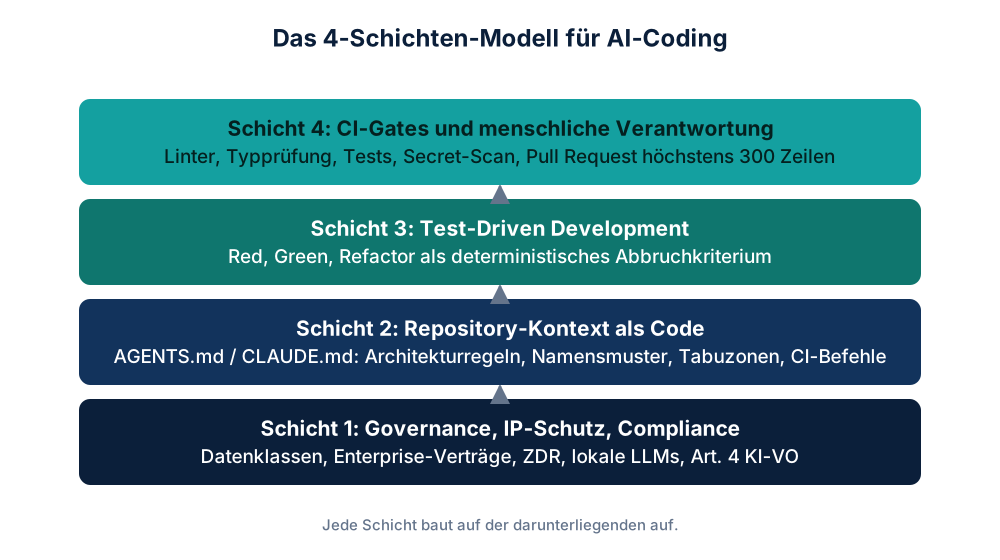
 +-------------------------------------------------------------------+
 |  Schicht 4: Deterministische CI-Gates & Menschliche Verantwortung |
 |  (Linter, Typprüfung, Unit-Tests, Secret-Scan, PR <= 300 Zeilen)  |
 +-------------------------------------------------------------------+
                                  ^
                                  |
 +-------------------------------------------------------------------+
 |  Schicht 3: Test-Driven Development (TDD) als Kontrollschleife    |
 |  (Red -> Green -> Refactor; deterministisches Abbruchkriterium)   |
 +-------------------------------------------------------------------+
                                  ^
                                  |
 +-------------------------------------------------------------------+
 |  Schicht 2: Repository-Kontext als Code (AGENTS.md / CLAUDE.md)   |
 |  (Architekturregeln, Namensmuster, Tabuzonen, CI-Befehle)         |
 +-------------------------------------------------------------------+
                                  ^
                                  |
 +-------------------------------------------------------------------+
 |  Schicht 1: Governance, IP-Schutz & Compliance                    |
 |  (Datenklassen, Enterprise-Verträge, ZDR, lokale LLMs, Art. 4)    |
 +-------------------------------------------------------------------+
Schicht 1: Governance, Quellcode-Schutz und rechtliche Leitplanken
Bevor Mitarbeiter Codefragmente in externe Sprachmodelle übermitteln, benötigt das Unternehmen verbindliche Richtlinien für vier Kernfragen:
- Klassifizierung von Repositories: Unterscheidung zwischen öffentlichem Code, internen Standardkomponenten, geschäftskritischer Domänenlogik und Quellcode mit personenbezogenen Daten oder Geheimnissen.
- Vertragliche Prüfung der Modellanbieter:
- - GitHub Copilot Business / Enterprise: GitHub sichert vertraglich zu, Eingaben nicht für das Modelltraining heranzuziehen. Über administrative Content Exclusions können vertrauliche Dateien ausgeschlossen werden – diese Ausschlussfunktion variiert jedoch je nach Feature (z. B. Inline-Vervollständigung vs. Chat/PR-Zusammenfassungen) und verhindert nicht pauschal jede Datenübermittlung. Quellen: GitHub Copilot Data Handling und Content Exclusion.
- - Anthropic Commercial Services: Kommerzielle API-Endpunkte schließen Modelltraining auf Kunden-Prompts standardmäßig aus; für spezifische Anforderungen können Vereinbarungen mit Zero Data Retention (ZDR) geschlossen werden. Quelle: Anthropic Commercial Terms.
- Lokale Open-Weight-Modelle: Für hochsensiblen Code, der Cloud-Umgebungen nicht verlassen darf, werden lokale Inferenz-Engines (z. B. Ollama im Firmennetzwerk) bereitgestellt.
- Sicherheitsrisiken kennen: Die OWASP Top 10 for LLM Applications (Fassung 2025) nennen Prompt Injection, Sensitive Information Disclosure und Excessive Agency als konkrete Bedrohungen.
- Regulatorische Anforderungen: Die Pflicht zur Sicherstellung ausreichender KI-Kompetenz (AI literacy) für Personal, das mit KI-Systemen arbeitet, gemäß Art. 4 der EU-KI-Verordnung (Verordnung (EU) 2024/1689; Quelle: EUR-Lex). Technische Governance schafft die Grundlagen, ersetzt jedoch keine juristische Beratung.
Schicht 2: Repository-Kontext als Code (AGENTS.md)
Ein Sprachmodell besitzt kein implizites Wissen über firmeninterne Architekturprinzipien. Liegen diese Regeln nur in Wikis oder Mitarbeiterköpfen, scheitert der Assistent an systemspezifischen Konventionen.
Die Lösung ist eine versionierte Steuerungsdatei direkt im Git-Repository (z. B. AGENTS.md oder CLAUDE.md):
- Verzeichnisstruktur & Schichtengrenzen: Welche Abhängigkeiten sind strikt untersagt?
- Ausführbare CI-Befehle: Exakte Shell-Kommandos für Build, Formatierung, Linting und Unit-Tests.
- Namenskonventionen & Anti-Patterns: Explizite Codebeispiele für erwünschte und verbotene Muster.
- Tabuzonen: Klar definierte Bereiche, die Modelle niemals selbstständig modifizieren dürfen (z. B. generierte Typen, DB-Migrationen, API-Secrets).
Da diese Konfigurationsdatei im Git-Tree liegt, wird sie bei jedem Pull Request wie Quellcode gereviewt. Korrigiert ein Entwickler ein wiederkehrendes Fehlverhalten des Assistenten, wird die Regel in der AGENTS.md festgeschrieben – das günstigste und wirksamste Wissensmanagement im Softwareteam.
Schicht 3: Test-Driven Development (TDD) als deterministisches Abbruchkriterium
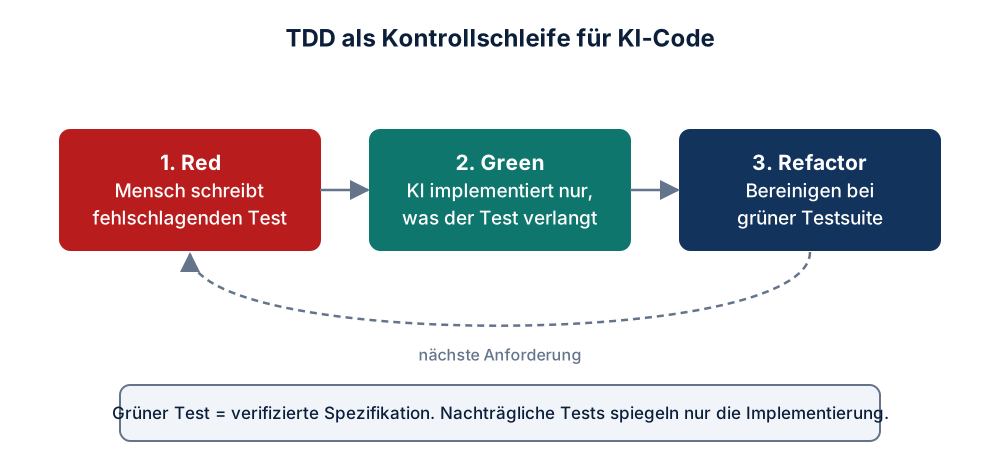
Da Large Language Models probabilistisch arbeiten, benötigen sie ein deterministisches Stoppsignal. Dieses Signal ist ein automatisierter Test.
- Im klassischen TDD-Zyklus (Red – Green – Refactor) definiert der Entwickler vorab die fachliche Anforderung:
- Red: Der Entwickler schreibt einen präzisen, fehlschlagenden Unit- oder Integrationstest, der das geforderte Verhalten und Randfälle festlegt.
- Green: Das KI-Modell erhält den Auftrag, ausschließlich den Code zu implementieren, der notwendig ist, um diesen Test grün zu machen.
- Refactor: Entwickler und Assistent bereinigen den Code unter Beibehaltung der grünen Testsuite. Quellen: Martin Fowler, Test Driven Development; Kent Beck, Test Driven Development: By Example.
Kritischer Kontrollpunkt: Werden Tests nachträglich zu bereits generiertem Code erzeugt, besteht das akute Risiko, dass der Test lediglich die bestehende Implementierung spiegelt – inklusive aller Denkfehler und unbedachter Grenzfälle. Ein nachträglicher Test beweist nur, wie der Code arbeitet, nicht ob er die Anforderung korrekt erfüllt. Test-First erzwingt kleine, prüfbare Diffs und verankert echtes Problemverständnis beim Menschen.
Schicht 4: Deterministische CI-Gates und menschliche Verantwortung
Alles, was maschinell validierbar ist, muss zwingend in der CI/CD-Pipeline automatisiert werden – reproduzierbar, bei jedem Push, ohne manuelle Diskussion:
- Syntax- und Formatprüfung (
dotnet format, Prettier) - Statische Typprüfung (
tsc --noEmit, strikte Compiler-Flags) - Vollständige automatisierte Testsuite (xUnit, Vitest)
- Sicherheitsprüfungen: Vulnerability-Scans von Abhängigkeiten und Secret-Scanning (
gitleaks).
Was die Pipeline nicht prüfen kann – passt die architektonische Entscheidung zur Domäne? Ist die Abstraktion tragfähig? –, verbleibt vollumfänglich in der Verantwortung des menschlichen Reviewers.
- Zwei unverzichtbare Team-Regeln:
- Pull Requests deckeln: KI erzeugt hunderte Zeilen in Sekunden. Reviewer sind überfordert und winken Änderungen unkritisch durch („Rubber Stamping“). Als praxiserprobte Heuristik gilt eine Obergrenze von 200 bis 300 geänderten Zeilen pro Pull Request inklusive Tests.
- Lückenlose Nachvollziehbarkeit: Der einreichende und der reviewende Entwickler tragen die volle fachliche und rechtliche Verantwortung für den Code – unabhängig davon, wer ihn getippt hat.
Enablement an Produktiv-Repositories statt Spielzeug-Demos
Effektives Team-Enablement unterscheidet sich grundlegend von Tool-Schulungen an isolierten Beispiel-Apps. Echte Reibung entsteht an historisch gewachsenen Codebasen: unklare Schichten, veraltete Bibliotheken und lückenhafte Tests.
- Ein wirksamer Enablement-Sprint setzt direkt an den produktiven Repositories an:
- Gemeinsames Erarbeiten der versionsspezifischen
AGENTS.mdam echten Codebase. - Exemplarische Umsetzung eines realen Backlog-Tickets im strengen TDD-Zyklus mit dem KI-Assistenten.
- Härtung und Vervollständigung der lokalen und serverseitigen CI-Gates.
- Etablierung verbindlicher Team-Standards für PR-Größen und Review-Routinen.
Die Wahl des konkreten Werkzeugs (GitHub Copilot, Cursor, Claude Code, Codex CLI) ist dabei zweitrangig. Werkzeuge wechseln; ein tragfähiges 4-Schichten-Modell bleibt über Technologiewellen hinweg stabil.
Häufig gestellte Fragen (FAQ)
### Warum reicht der bloße Kauf von Copilot- oder Cursor-Lizenzen im Team nicht aus? Lizenzen beschleunigen lediglich das Tippen von Code, nicht dessen Prüfung und Wartung. Ohne einheitliche Standards führt ungebremste KI-Codegenerierung zu unkontrolliertem Code Churn, fragmentierten Abhängigkeiten und massiven Engpässen im Code-Review, wodurch der tatsächliche Team-Durchsatz stagniert.
### Welche Rolle spielt eine AGENTS.md oder CLAUDE.md im Repository? Sie fungiert als maschinenlesbarer Systemkontext für KI-Assistenten direkt im Git-Repository. Sie definiert Schichtengrenzen, Namenskonventionen, CI-Befehle und verbotene Codemuster. Sie verhindert falsche Modell-Annahmen und wird wie Programmcode versioniert und weiterentwickelt.
### Warum ist Test-Driven Development (TDD) bei der KI-Codeerzeugung unverzichtbar? Da Sprachmodelle stochastisch arbeiten, benötigen sie ein deterministisches Ziel. Im TDD-Zyklus formuliert der Entwickler vorab Sollverhalten und Randfälle als Test. Erst wenn der Test grün wird, ist verifiziert, dass das Modell die Spezifikation erfüllt. Nachträglich generierte Tests spiegeln dagegen meist nur die Fehler der Implementierung wider.
### Welche rechtlichen Vorgaben gelten für AI-Coding im Enterprise-Umfeld? Unternehmen müssen Quellcode schützen und vertraglich ausschließen, dass sensible Geschäftslogik zum Modelltraining verwendet wird. Zudem verlangt Art. 4 der EU-KI-Verordnung (AI Act) die Sicherstellung angemessener KI-Kompetenz (AI literacy) bei Mitarbeitern. Urheberrechts- und Haftungsfragen verbleiben vollumfänglich beim Entwickler und Unternehmen.
Nächste Schritte für Ihr Entwicklungsteam
Wenn Sie AI-Coding in Ihrem Team strukturiert, messbar und mit klaren Governance-Leitplanken am eigenen Quellcode einführen möchten:
- Erfahren Sie mehr über unsere praxisnahen Workshop- und Sprint-Formate auf der Leistungsseite KI-Transformation.
- Quellenverzeichnis (alle Primärquellen abgerufen am 19.11.2026):
- Peng, Kalliamvakou, Zhou, Li, Shen, et al. (2023): The Impact of AI on Developer Productivity: Evidence from GitHub Copilot, arXiv:2302.06590.
- GitClear Research (2024 & 2025): Coding on Copilot: Data Shows Downward Pressure on Code Quality, gitclear.com/coding_on_copilot_data_shows_ais_downward_pressure_on_code_quality und www.gitclear.com/ai_assistant_code_quality_2025_research.
- DORA / Google Cloud (2024): 2024 Accelerate State of DevOps Report, dora.dev/research/2024/dora-report/2024-dora-accelerate-state-of-devops-report.pdf.
- GitHub Docs: GitHub Copilot Data Handling and Privacy, docs.github.com/en/copilot/concepts/data-handling sowie Content Exclusion, docs.github.com/en/copilot/concepts/content-exclusion.
- Anthropic: Commercial Terms of Service, anthropic.com/legal/commercial-terms.
- OWASP Foundation: OWASP Top 10 for Large Language Model Applications (2025), owasp.org/www-project-top-10-for-large-language-model-applications/.
- Europäische Union: Verordnung (EU) 2024/1689 (EU-KI-Verordnung / AI Act), eur-lex.europa.eu/eli/reg/2024/1689/oj.
- Martin Fowler: Test Driven Development, martinfowler.com/bliki/TestDrivenDevelopment.html.
- Kent Beck: Test Driven Development: By Example, Addison-Wesley, ISBN 0-321-14653-0.