
Lokale LLMs, EU-Cloud oder Enterprise-Copilot: Wie Sie Quellcode beim Einsatz von KI schützen
Der Schutz von Quellcode beim Einsatz generativer KI erfordert eine differenzierte Einteilung nach Schutzbedarf statt pauschaler Verbote: Ein Drei-Zonen-Modell trennt internen Standardcode (Enterprise-IDE-Suiten mit vertraglichem Trainingsausschluss), sensible Fachdaten und Schnittstellen (dedizierte EU-Cloud-Endpunkte mit Datenresidenz und rollenbasierter Zugriffskontrolle) sowie hochsensiblen Kerncode oder historische Schemata (vollständig lokale Modelle oder deterministische Anonymisierung). Klare Governance, Secret-Scanning und Berechtigungsbeschränkungen für MCP-Agenten sichern den Einsatz praxistauglich ab.
Entwicklerinnen und Entwickler drängen in fast jedem Software-Team darauf, KI-gestützte Programmierassistenten wie GitHub Copilot, Cursor oder Claude Code einzusetzen. Auf der anderen Seite stehen IT-Sicherheitsbeauftragte, Justiziare und Führungskräfte, die zu Recht den unkontrollierten Abfluss von geistigem Eigentum, Geschäftsgeheimnissen oder Kundendaten fürchten.
Das häufige Resultat dieser Spannung ist ein pauschales Verbot auf dem Papier. In der Praxis führt dies jedoch fast immer zu unkontrollierter Schatten-IT: Entwickler weichen auf private Bezahlkonten oder Web-Chat-Oberflächen aus, deren Lizenz- und Datenschutzbedingungen im Unternehmen niemand geprüft hat. Quellcode wird fragmentiert in Browser kopiert, ohne dass IT-Sicherheit oder Compliance davon erfahren.
Ein geplanter, transparenter Rollout mit klaren Schutzzonen schützt Ihren Code um ein Vielfaches wirksamer als Verbote, die technisch und organisatorisch nicht durchgesetzt werden können. Dieser Fachartikel vergleicht vier primäre Betriebsmodelle, klärt verbreitete Datenschutzirrtümer auf und stellt ein praxiserprobtes Drei-Zonen-Modell vor. Er stellt keine Rechtsberatung dar; die vertraglichen Bedingungen der Modellanbieter ändern sich dynamisch und müssen vor jedem Rollout im Beschaffungsprozess verifiziert werden.
+--------------------------------------------------------------------------+
|                       Drei-Zonen-Modell für KI-Coding                    |
+--------------------------------------------------------------------------+
|  Zone 1: Standardcode & Tests         --> Enterprise-IDE-Suite           |
|                                           (Copilot Business/Enterprise)  |
+--------------------------------------------------------------------------+
|  Zone 2: Fachdaten, interne APIs      --> Dedizierter EU-Cloud-Endpunkt  |
|                                           (Azure OpenAI mit EU Data Zone)|
+--------------------------------------------------------------------------+
|  Zone 3: Kernalgorithmen & Altsysteme --> Lokale LLMs / On-Prem Inferenz |
|                                           (Ollama / determinist. Anonym.)|
+--------------------------------------------------------------------------+
Drei weitverbreitete Irrtümer beim Datenschutz von KI-Coding-Werkzeugen
### Irrtum 1: „Ein bezahlter Account garantiert Enterprise-Datenschutz“ Viele Teams glauben, ein Pro-Abo für 20 Dollar im Monat schütze vor dem Training der KI-Modelle. Das ist rechtlich und technisch falsch.
- Einzelnutzer-Tarife (Consumer- oder Individual-Pläne) und echte Firmenverträge (Enterprise- bzw. Business-Agreements) sind rechtlich getrennte Produkte mit grundlegend unterschiedlichen Datenverarbeitungsbedingungen:
- GitHub Copilot: Dass Code-Snippets und Telemetrie nicht für das Training von Modellen verwendet werden, ist verbindlich in den Bedingungen für GitHub Copilot Business und GitHub Copilot Enterprise geregelt. Individuelle Copilot-Abonnements unterliegen anderen Richtlinien. Quelle: GitHub Copilot Trust Center, abgerufen am 21.11.2026.
- Anthropic Commercial Terms: In den kommerziellen Tarifen für Teams und Unternehmen schließen die Geschäftsbedingungen das Training auf Kundeneingaben aus. Ein vollständiger Verzicht auf temporäre Speicherung (Zero Data Retention / ZDR) erfordert jedoch gesonderte vertragliche Vereinbarungen bzw. Anträge. Quelle: Anthropic Commercial Terms, abgerufen am 21.11.2026.
Prüfen Sie vor dem Freigabeprozess exakt, über welche Vertragsart Ihre Mitarbeiter tatsächlich zugreifen.
- ### Irrtum 2: „Eine Azure-Ressource in West Europe garantiert EU-Datenresidenz“
- Azure-OpenAI-Dienste in europäischen Regionen (wie
West EuropeoderSweden Central) bieten hohe Sicherheitsstandards. Dennoch hängt die tatsächliche Datenverarbeitung vom gewählten Deployment-Typ ab: - Global Deployment: Ermöglicht Microsoft, Inferenzanfragen dynamisch weltweit an verfügbare Rechenzentren zu routen, um Lastspitzen abzufangen. Ruhende Daten verbleiben zwar am Speicherort, die Verarbeitung erfolgt jedoch nicht zwingend in der EU.
- EU Data Zone & Regional Deployments: Nur bei expliziter Wahl eines regionalen Deployments oder einer dedizierten EU Data Zone wird garantiert, dass die Inferenzverarbeitung geografisch auf die Europäische Union beschränkt bleibt.
- Abuse Monitoring: Standardmäßig speichert Microsoft Eingaben und Ausgaben für bis zu 30 Tage zur Missbrauchserkennung. Für regulierte und besonders vertrauliche Szenarien bietet Microsoft ein modifiziertes Abuse Monitoring (ohne Prompts-Speicherung) an, das jedoch formal beantragt und genehmigt werden muss. Seit dem 1. November 2026 gelten für neue Modelle aktualisierte Berechtigungskriterien. Quelle: Microsoft Learn, Data, privacy and security for Azure OpenAI, abgerufen am 21.11.2026.
### Irrtum 3: „GitHub Content Exclusions lösen das Problem vollständig“ Mit der Funktion Content Exclusion können Administratoren in GitHub bestimmte Repositories, Zweige oder Dateipfade für GitHub Copilot sperren. Diese Blockade greift zuverlässig in den von GitHub kontrollierten Oberflächen (z. B. Web-Editor, offizielle Copilot-Plugins in VS Code und JetBrains).
Sie stellt jedoch keine Dateisystem-Berechtigung auf Entwickler-Workstations dar. Ein lokal laufender CLI-Agent, ein angebundener Model Context Protocol (MCP) Server oder ein alternatives KI-Tool kann weiterhin ungehindert auf dieselben Dateien zugreifen, sofern das Werkzeug über Lesezugriff im lokalen Workspace verfügt. Quelle: GitHub Docs, Exclude content from GitHub Copilot, abgerufen am 21.11.2026.
Vier Betriebsmodelle im Vergleich
| Betriebsmodell | Primäre Stärken | Wichtige Einschränkungen & Prüfpunkte |
|---|---|---|
| 1. Enterprise-IDE-Suite<br>(z. B. GitHub Copilot Business / Enterprise) | Nahtlose IDE-Integration, zentrale Policy-Verwaltung, Pfad-Ausschlüsse, vertraglicher Ausschluss von Modelltraining auf Kundencode. | Wirkung der Ausschlüsse endet an den Grenzen der Suite. Gilt nicht für separate MCP-Tools oder CLI-Agenten. |
| 2. Kommerzieller CLI- & API-Zugang<br>(z. B. Claude Code im Team-/Enterprise-Tarif) | Mächtige agentische Fähigkeiten für mehrstufige Refactorings und Repository-Analysen; kein Training auf Kundencode. | Zero Data Retention (ZDR) erfordert gesonderte Vereinbarung. Feedback- und Bug-Report-Befehle senden bewusst Telemetrie an den Hersteller. |
| 3. Dedizierter EU-Cloud-Endpunkt<br>(z. B. Azure OpenAI mit EU Data Zone) | Datenresidenz in der EU, unternehmensweite Azure-Governance, Private Endpoints im VNet, kein Training auf Kundendaten. | Deployment-Typ muss bewusst als Regional oder EU Data Zone gewählt werden. Modifiziertes Abuse Monitoring muss beantragt werden. |
| 4. Lokale Open-Weights-Modelle<br>(z. B. über Ollama auf lokaler Workstation / On-Prem) | Vollständige Datenisolation: Quellcode verlässt niemals die eigene Hardware. Funktioniert komplett offline. | Hohe Anforderungen an lokale GPU/VRAM-Ausstattung. Kleinere Modelle erreichen bei komplexen, dateiübergreifenden Architekturen oft nicht die Präzision der Spitzen-Cloud-Modelle. |
Ollama bindet seinen API-Dienst in der Standardkonfiguration an die Loopback-Adresse 127.0.0.1:11434, wodurch der Dienst zunächst nur dem lokalen Rechner zur Verfügung steht. Quelle: Ollama GitHub Repository, abgerufen am 21.11.2026. Ob das Gesamtsystem isoliert bleibt, hängt jedoch von der Systemumgebung ab: Wer den Dienst an externe Netzwerkinterfaces bindet (0.0.0.0) oder dem Modell Werkzeuge mit uneingeschränktem Internetzugriff bereitstellt, durchbricht die Isolation selbst.
Das Drei-Zonen-Modell: Pragmatische Klassifizierung nach Schutzbedarf
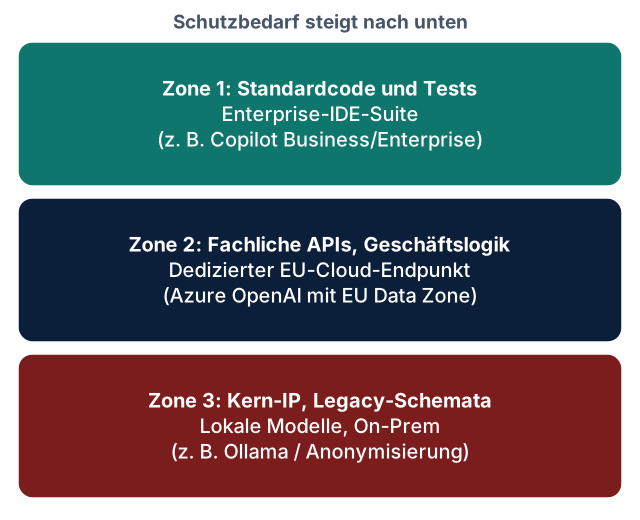
Anstelle dogmatischer Alles-oder-Nichts-Entscheidungen ordnet das Drei-Zonen-Modell Codebestände nach ihrem realen Schutzbedarf:
                            Sicherheitsanforderung
                                      ^
                                      |
      [ Zone 3: Streng vertraulich ]  |  Lokale LLMs (Ollama) /
        - Kern-IP, Altsystem-Code     |  Deterministische Anonymisierung
        - Geschäftsgeheimnisse        |  Keine externe Datenübertragung
                                      |
      [ Zone 2: Intern vertraulich ]  |  Dedizierter EU-Cloud-Endpunkt
        - Fachlogik, Schnittstellen   |  (Azure OpenAI EU Data Zone)
        - Interne API-Verträge        |  Rollenbasierte Azure-Governance
                                      |
      [ Zone 1: Standardcode ]        |  Enterprise-IDE-Suiten
        - Boilerplate, UI, Tests      |  (Copilot Business / Enterprise)
        - Generische Hilfsfunktionen  |  Vertraglicher Trainingsausschluss
                                      +---------------------------------->
Produktivität- ### Zone 1: Interner Standardcode, Boilerplate und Tests
- Typischer Anwendungscode, UI-Komponenten, Standard-Unit-Tests und Infrastruktur-Templates ohne sensible Geschäftsgeheimnisse.
- Empfehlung: Einsatz von Enterprise-IDE-Suiten (wie GitHub Copilot Business) mit zentralen Richtlinien, automatisiertem Secret-Scanning und obligatorischem Vier-Augen-Code-Review.
- Nutzen: Hoher Produktivitätsgewinn bei minimalem Restrisiko.
- ### Zone 2: Fachliche Unternehmensdaten, interne APIs und Dokumentation
- Hier geht es um Kernkomponenten mit geschäftlicher Sensibilität, interne Domänen-APIs und vertrauliche Architekturdokumente.
- Empfehlung: Anbindung über dedizierte EU-Cloud-Endpunkte (wie Azure OpenAI mit EU Data Zone).
- Nutzen: Datenresidenz innerhalb der EU, Einbindung in die unternehmensweite Identitäts- und Rollenverwaltung (Microsoft Entra ID) und vollständige Protokollierung aller Zugriffe im eigenen Azure-Tenant.
- ### Zone 3: Hochsensible Kernsysteme, historische Datenbanken und Geschäftsgeheimnisse
- Proprietäre Kernalgorithmen, Altsystem-Datenbanken mit historischen Beständen oder hochregulierte Quellcode-Bereiche.
- Empfehlung: Vollständig lokal betriebene Open-Weights-Modelle oder eine vorgelagerte deterministische Anonymisierung, bevor Codefragmente externe Dienste passieren.
- Praxiseinsatz: Für die Extraktion von Geschäftsregeln aus alten Systemen (z. B. ColdFusion oder Classic ASP) hat sich ein lokal indizierter Wissensbestand mit lokalem Modell in der Praxis bewährt. Die Analyse und Aufbereitung erfolgt vollständig isoliert im eigenen Rechenzentrum.
Fünf verbindliche Leitplanken vor dem Team-Rollout
- Vertragskonten technisch erzwingen: Stellen Sie sicher, dass Entwickler ausschließlich mit Firmenkonten unter freigegebenen Enterprise-Agreements arbeiten. Sperren Sie den Zugriff auf private KI-Dienste über das Firmennetzwerk administrativ ab.
- Secrets rigoros ausfiltern: Ein vertraglicher Trainingsausschluss schützt nicht davor, dass hartcodierte API-Schlüssel, Passwörter oder Zertifikate versehentlich in Modell-Prompts landen. Pre-Commit-Hooks, Secret-Scanning (z. B. Gitleaks) und strikte
.gitignore-Regeln sind Pflicht. - Werkzeugrechte nach dem Least-Privilege-Prinzip beschränken: Wenn CLI-Agenten oder MCP-Server eingesetzt werden, dürfen diese nur auf die zwingend benötigten Pfade zugreifen. Schreibende Aktionen im Repository müssen immer unter menschlicher Freigabe (Human-in-the-Loop) stehen. Dies schützt vor bekannten Risiken der OWASP Top 10 for LLM Applications (2025) wie Prompt Injection, Offenlegung sensibler Daten und übermäßiger Handlungsfreiheit (Excessive Agency). Vertiefende Architekturmuster hierzu finden Sie im Artikel KI-Agenten und MCP in CI/CD-Pipelines.
- Code-Qualität durch TDD absichern: Ohne methodische Führung führt ungeprüfter KI-Code zu erhöhtem Wartungsaufwand. Eine empirische Studie von GitClear über mehr als 150 bis 200 Millionen Codezeilen beobachtete einen Anstieg von Code-Churn und einen Rückgang des Anteils refaktorierter Zeilen bei ungelenktem KI-Einsatz (GitClear Research, abgerufen am 21.11.2026). Test-Driven Development (TDD) und automatisierte Test-Pipelines wirken diesem Qualitätsverlust entgegen; Details beschreibt der Artikel AI-Coding Enablement: Governance, Regeln und TDD im Team.
- Vertrags- und Produktzyklen regelmäßig monitoren: Anbieter passen Nutzungsbedingungen, Logging-Zeiträume und Opt-out-Verfahren regelmäßig an. Legen Sie im Architekturgremium fest, wer diese Bedingungen quartalsweise auditiert.
Häufig gestellte Fragen (FAQ)
### Dürfen wir unseren Quellcode nach der DSGVO überhaupt an KI-Dienste übermitteln? Reiner Quellcode ohne personenbezogene Daten (wie Kundennamen, private E-Mail-Adressen oder reale PII in Testdaten) unterliegt nicht der DSGVO, sondern dem Schutz des geistigen Eigentums und Geschäftsgeheimnisses. Enthalten Kommentare, Commits oder Test-Fixtures jedoch reale personenbezogene Daten, greift die DSGVO vollumfänglich. In diesem Fall sind ein formaler Auftragsverarbeitungsvertrag (AVV), geklärte Datenresidenz (z. B. EU Data Zone) und die Verhinderung des Modelltrainings zwingende rechtliche Voraussetzungen.
### Reichen lokal betriebene Modelle für anspruchsvolle Software-Architekturaufgaben aus? Für spezialisierte Aufgaben wie die Regelextraktion aus Altcode, Schemaanalysen oder das Verfassen lokaler Unit-Tests liefern moderne lokale Open-Weights-Modelle auf geeigneter Hardware sehr solide Ergebnisse. Bei komplexen, repository-weiten Architekturrefactorings, die ein tiefes Verständnis hunderter interagierender Klassen erfordern, sind die größten kommerziellen Cloud-Modelle derzeit noch spürbar überlegen. Hier bietet sich das Drei-Zonen-Modell an: lokale Analyse für Zone 3, anonymisierte Teilaufgaben über EU-Cloud-Endpunkte für Zone 2.
### Wie verhindern wir, dass Entwickler über private Accounts Firmenquellcode leaken? Verbote allein verhindern Schatten-IT selten. Der wirksamste Hebel besteht darin, dem Team ein offizielles, komfortables und voll lizenziertes Werkzeug (wie GitHub Copilot Enterprise oder einen kuratierten Claude-Code-Zugang) bereitzustellen, das im Firmennetzwerk freigegeben ist. Gleichzeitig müssen nicht autorisierte Web-URLs per Firmen-Proxy gesperrt und automatisierte Secret-Scanner in die CI/CD-Pipeline integriert werden.
### Verhindert GitHub Content Exclusion auch, dass MCP-Agenten vertrauliche Dateien lesen? Nein. Die GitHub Content Exclusion wirkt ausschließlich innerhalb der von GitHub kontrollierten Werkzeuge und Erweiterungen. Ein lokaler Agent oder MCP-Server, der direkt auf dem Dateisystem der Entwickler-Maschine operiert, ignoriert diese Einstellung, sofern die Dateien nicht auf Betriebssystemebene oder über eine explizite Werkzeug-Konfiguration (z. B. .ignore-Dateien des Agenten) gesperrt sind. Werkzeugrechte müssen daher auf Betriebssystem- und Workspace-Ebene isoliert werden.
Nächste Schritte
Möchten Sie KI-Assistenten in Ihrer Entwicklungsorganisation einführen, ohne die Kontrolle über Ihren Quellcode und Ihre Datenhoheit zu verlieren?
- Einen fundierten Überblick über unser Beratungsangebot zu Werkzeugauswahl, Governance und Governance-Regeln finden Sie unter KI-Transformation.
- Konkrete Umsetzungsbegleitung für sichere KI-Workflows und RAG-Pipelines bietet der Leistungsbereich KI Business Solutions.
- Quellen (abgerufen am 21.11.2026):
- GitHub Copilot Trust Center:
https://docs.github.com/en/copilot/responsible-use-of-github-copilot/features-for-enterprise - GitHub Docs, Configure content exclusion:
https://docs.github.com/en/copilot/how-tos/configure-content-exclusion/exclude-content-from-copilot - Microsoft Learn, Data, privacy and security for Azure OpenAI:
https://learn.microsoft.com/en-us/azure/ai-services/openai/concepts/data-privacy - Anthropic Commercial Terms:
https://www.anthropic.com/legal/commercial-terms - Ollama Repository (Standard-Bindung und Konfiguration):
https://github.com/ollama/ollama - OWASP Top 10 for LLM Applications (2025):
https://owasp.org/www-project-top-10-for-large-language-model-applications/ - GitClear Research, Coding on Copilot Data Analysis:
https://www.gitclear.com/coding_on_copilot_data_shows_downward_trend_code_quality