
KI-Pilot im Mittelstand: Von der Dokumentensuche zum verlässlichen RAG-Workflow in 2 bis 4 Wochen
Ein praxistauglicher KI-Pilot im Mittelstand konzentriert sich auf einen klar abgegrenzten Engpass, wie die semantische Suche in internen Fachrichtlinien oder Angebotsarchiven, statt generische Chatbots auszurollen. Mittels Retrieval-Augmented Generation (RAG) beantwortet das System Anfragen ausschließlich auf Basis geprüfter Unternehmensdokumente mit präzisen Quellenangaben. Laut Statistik Austria (Erhebung 2026) nutzen 48 Prozent der österreichischen Betriebe ab zehn Beschäftigten KI. Ein realistischer Planungsrahmen von zwei bis vier Wochen reicht für einen messbaren Prototyp.
In den allermeisten Unternehmen haben Geschäftsführung und Abteilungsleiter bereits mit generativer KI experimentiert. Ein Chatfenster im Browser ist schnell geöffnet, und für das Formulieren von E-Mails, das Zusammenfassen von Pressemitteilungen oder das Brainstorming funktioniert die Technologie beeindruckend gut.
- Die eigentliche Hürde beginnt jedoch genau an dem Punkt, an dem aus gelegentlichen Textentwürfen ein verlässlicher, geschäftskritischer Arbeitsprozess werden soll:
- Wie durchsuchen Mitarbeiter technische Handbücher, Normen und interne Richtlinien treffsicher?
- Wie beschleunigt der Vertrieb die Angebotserstellung auf Basis hunderter früherer Ausschreibungen?
- Wie lassen sich Daten aus Eingangsbelegen fehlerfrei extrahieren?
Versuche, diese Aufgaben mit einfachen Standard-Chatbots zu lösen, scheitern in der Praxis selten an der Rechenleistung der Sprachmodelle. Sie scheitern an fehlendem Anwendungszuschnitt, unklaren Datenschutzgrenzen, mangelhafter Dokumentenaufbereitung und dem Fehlen einer systematischen Qualitätsmessung.
Dieser Leitfaden zeigt, wie mittelständische Betriebe ein erfolgreiches Pilotprojekt aufsetzen: mit einem scharf umrissenen Engpass, kontrollierter Datenarchitektur, fundierten Sicherheitsleitplanken und einem klaren Entscheidungskriterium am Ende.
+--------------------------------------------------------------------------+
|                     Architektur eines Enterprise-RAG-Workflows           |
+--------------------------------------------------------------------------+
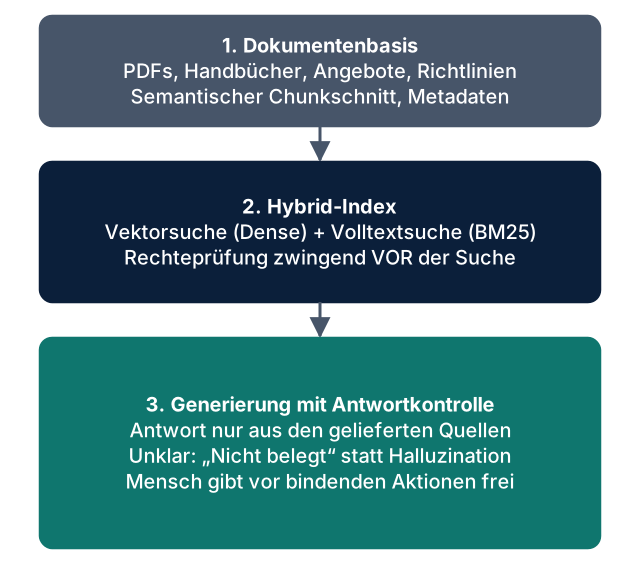
|  1. Dokumentenbasis: PDFs, Handbücher, Angebote, Richtlinien             |
|     (Vorverarbeitung: Semantischer Chunkschnitt, Metadaten-Extraktion)    |
+------------------------------------+-------------------------------------+
                                     |
                                     v
+--------------------------------------------------------------------------+
|  2. Hybrid-Index: Vektoreinbettung (Dense) + Volltextsuche (BM25)        |
|     (Rechteprüfung ZWINGEND vor der Suche: Mandanten- & Rollenfilter)    |
+------------------------------------+-------------------------------------+
                                     |
                                     v
+--------------------------------------------------------------------------+
|  3. Generierung & Antwortkontrolle (LLM Inferenz)                        |
|     - Strikte Quellenbindung: Antwort nur aus mitgelieferten Chunks      |
|     - Kein Halluzinieren: System antwortet "Nicht belegt", wenn unklar   |
|     - Human-in-the-Loop: Menschliche Freigabe vor bindenden Aktionen     |
+--------------------------------------------------------------------------+
Die empirische Ausgangslage in Österreich
Laut der aktuellen Erhebung von Statistik Austria zum IKT-Einsatz in Unternehmen (veröffentlicht am 20. Oktober 2026) setzen mittlerweile 48 Prozent der österreichischen Unternehmen ab zehn Beschäftigten künstliche Intelligenz ein (in den Detailtabellen sind 48,7 % ausgewiesen).
Im Vergleich zum Erhebungsjahr 2025 – in dem die KI-Nutzung in Österreich bei rund 30 Prozent lag, während der damalige EU-Schnitt bei 20 Prozent verharrte – zeigt dies eine massive Beschleunigung der praktischen Einführung. Zugleich belegt die vorangegangene Detailanalyse von Statistik Austria (Pressemitteilung vom 24. Juni 2026), dass 77 Prozent der Betriebe, die noch keine KI einsetzten, eine Einführung damals noch gar nicht strukturiert in Erwägung gezogen hatten. Quelle: Statistik Austria, IKT-Einsatz in Unternehmen, abgerufen am 21.11.2026.
- Diese Daten decken sich exakt mit unserer praktischen Beratungserfahrung: Das grundsätzliche Interesse ist flächendeckend vorhanden. Was vielen Geschäftsführern und IT-Leitern jedoch fehlt, ist die methodische Orientierung:
- Welcher konkrete Prozess eignet sich für einen risikofreien Einstieg?
- Welche Architektur garantiert die Einhaltung europäischer Datenschutzstandards?
- Wie wird verhindert, dass das System falsche Fakten („Halluzinationen“) generiert?
Die Wirtschaftskammer Österreich (WKO) rät in ihren Leitlinien für Unternehmen ausdrücklich dazu, nicht in langwierige, theoretische Grundsatzprojekte zu investieren, sondern mit eng abgegrenzten Pilotvorhaben, realistischen Zielen und vorab definierten Erfolgskriterien zu starten. Quelle: WKO, KI-Guidelines, abgerufen am 21.11.2026.
Das Leitprinzip: Ein Pilotprojekt muss sich selbst tragen
Ein KI-Pilot darf kein technologischer Selbstzweck sein. Planen Sie das Vorhaben so, dass der messbare Nutzen die Projektkosten bereits im Pilotbetrieb aus eigener Kraft rechtfertigt.
Der primäre wirtschaftliche Hebel im Mittelstand liegt fast immer in der Einsparung unproduktiver Such-, Prüf- und Übertragungszeiten. Beispiel: Wenn drei Fachkräfte im technischen Vertrieb täglich jeweils 45 Minuten damit verbringen, Spezifikationen und Sonderkonditionen aus archivierten Angeboten zusammenzusuchen, entspricht das über 450 Arbeitsstunden pro Jahr.
Messen Sie diesen Aufwand vor dem Start des Piloten für genau einen definierten Arbeitsschritt (Baseline). Nur wenn Sie die Ausgangszeit kennen, können Sie nach Abschluss des Piloten objektiv entscheiden, ob das System einen echten Produktivitätsfortschritt erbracht hat.
Warum offene Standard-Chatbots im Fachbereich scheitern
Der Reflex, einfach allen Mitarbeitern einen pauschalen Zugang zu einem allgemeinen Chatbot bereitzustellen, führt fast immer zur Enttäuschung.
Ein Sprachmodell ohne direkte Anbindung an Ihre internen Dokumente greift ausschließlich auf sein allgemeines Trainingswissen zurück. Bei spezifischen Fragen zu Ihren Betriebsvereinbarungen, Maschinenhandbüchern oder Kundenverträgen antwortet ein solches Modell entweder mit allgemeinen Floskeln oder erfindet plausible, aber falsche Angaben. Das Vertrauen der Belegschaft erodiert innerhalb weniger Tage.
- Für verlässliche Geschäftsprozesse sind drei Kernkomponenten unverzichtbar:
- Eine exakt abgegrenzte, geprüfte Dokumentenbasis.
- Deterministische Anweisungen zur Quellenbindung.
- Die Architektur von Retrieval-Augmented Generation (RAG).
Bei RAG durchsucht das System bei einer Benutzeranfrage zuerst eine interne Datenbank nach den relevantesten Textstellen Ihrer Originaldokumente. Anschließend werden ausschließlich diese geprüften Textabschnitte zusammen mit der Frage an das Sprachmodell übergeben. Das Modell formuliert die Antwort strikt auf Basis dieser Auszüge und weist das Quelldokument samt Seitenzahl transparent aus.
Vier typische Schwachstellen bei RAG-Lösungen in der Praxis
Das Microsoft Azure Architecture Center betont im RAG Solution Design and Evaluation Guide, dass der Erfolg einer RAG-Lösung primär von der Qualität der Vorverarbeitung, der Suchpräzision und einer systematischen Evaluation gegen Testdatensätze abhängt. Quelle: Microsoft Learn, RAG solution design and evaluation guide, abgerufen am 21.11.2026.
In der Praxis scheitern unprofessionell aufgesetzte Piloten regelmäßig an vier Konstruktionsfehlern:
- Naiver Textschnitt (Chunking): Dokumente werden starr nach Zeichenanzahl (z. B. alle 1.000 Zeichen) zerlegt. Tabellen, Absätze und Berechnungsformeln werden dadurch mitten im Satz zerschnitten. Zusammenhänge gehen verloren. Lösung: Semantisches Chunking entlang von Überschriften, Listen und Tabellenstrukturen.
- Reine Vektorsuche: Vektoreinbettungen (Dense Embeddings) finden sinngemäße Bedeutungen, scheitern jedoch häufig an exakten Artikelnummern, DIN-Normen, Personennamen oder Fehlercodes. Lösung: Hybrid Search, die semantische Vektorsuche mit klassischer Volltext-Stichwortsuche (BM25) und Re-Ranking kombiniert.
- Rechteprüfung nach der Inferenz: Wenn der Suchindex Dokumente verschiedener Abteilungen enthält und Berechtigungen nicht vorab gefiltert werden, können unbefugte Mitarbeiter über den Chatbot vertrauliche Gehaltsdaten oder Management-Memos abfragen. Lösung: Zugriffsrechte müssen zwingend vor der Suche über Metadaten-Filter auf Identitätsebene greifen.
- Fehlende systematische Evaluation: Ohne einen definierten Prüfkatalog weiß niemand, ob eine Anpassung der Systemprompts das Gesamtsystem verbessert oder an anderer Stelle verschlechtert hat.
Sicherheitsleitplanken nach OWASP Top 10 for LLM Applications
Die OWASP Top 10 for LLM Applications (Fassung 2025) identifizieren zentrale Risiken wie Prompt Injection, Offenlegung sensibler Informationen und übermäßige Handlungsfreiheit (Excessive Agency). Quelle: OWASP Top 10 for LLM Applications, abgerufen am 21.11.2026.
Für einen unternehmenstauglichen Piloten leiten sich daraus vier verbindliche Leitplanken ab:
- 1. Strikte Quellenbindung: Das Modell wird instruiert, Antworten ausschließlich aus den mitgelieferten Dokumentenabschnitten zu bilden. Kann eine Frage nicht belegt werden, antwortet das System transparent mit „Aus den vorliegenden Unterlagen nicht beantwortbar“, statt Mutmaßungen anzustellen.
- 2. Trennung von Steuerbefehl und Dateninhalt: Textinhalte aus eingelesenen Dokumenten sind reines Datenmaterial, niemals Systemanweisungen. Ein manipuliertes Dokument, das Sätze wie „Ignoriere alle bisherigen Befehle“ enthält (Indirect Prompt Injection), darf das Verhalten des Assistenten nicht manipulieren.
- 3. Pre-Search Access Control: Der Suchindex liefert nur Fragmente zurück, für die der jeweilige Benutzer im Quellsystem (z. B. Fileshare oder SharePoint) eine Leseberechtigung besitzt.
- 4. Human-in-the-Loop: Das KI-System dient der Vorbereitung und Recherche. Rechtsverbindliche Erklärungen, Angebotsversendungen oder Systemeinträge erfolgen erst nach Prüfung und Freigabe durch eine qualifizierte Fachkraft.
Der strukturierte Fahrplan in vier Schritten
Ein realistischer Planungsrahmen für einen fundierten RAG-Piloten umfasst zwei bis vier Wochen. Dies ist eine praxisnahe Planungsgröße, kein starres Leistungsversprechen: Die tatsächliche Umsetzungsdauer hängt maßgeblich davon ab, wie sauber und homogen die Ausgangsdokumente vorliegen.
### Schritt 1: Engpass definieren und Beispieldokumente isolieren (Woche 1) Wählen Sie genau einen schmerzhaften Anwendungsfall: beispielsweise die interne Suche in Montageanleitungen oder die Recherche in Projektberichten. Begrenzen Sie den Bestand für den Piloten auf 50 bis 200 saubere, repräsentative Dokumente.
- ### Schritt 2: Datenschutz und Betriebsmodell festlegen (Woche 1–2)
- Legen Sie fest, wo die Datenverarbeitung stattfindet. Für schützenswerte Unternehmensdaten stehen zwei saubere Modelle zur Verfügung:
- Ein dedizierter Cloud-Endpunkt mit garantierter Datenresidenz in der EU (z. B. Azure OpenAI mit EU Data Zone).
- Ein vollständig lokal betriebener Inferenz-Server auf eigener Hardware (z. B. via Ollama), wodurch keine Daten das Firmennetzwerk verlassen.
Verbraucher-Dienste ohne vertraglichen Trainingsausschluss sind tabu. Eine detaillierte Gegenüberstellung der Betriebsmodelle bietet unser Fachartikel Lokale LLMs, EU-Cloud oder Enterprise-Copilot.
### Schritt 3: Lauffähigen RAG-Prototyp bereitstellen (Woche 2–3) Innerhalb weniger Tage wird die Parsing- und Indexierungs-Pipeline aufgebaut. Die Dokumente werden aufbereitet, in einem Vektor- und Volltextindex abgelegt und an eine übersichtliche Weboberfläche angebunden. Jede Antwort liefert anklickbare Direktverweise auf die exakte Fundstelle im Originaldokument.
- ### Schritt 4: Mit Testfragen evaluieren und entscheiden (Woche 3–4)
- Erstellen Sie gemeinsam mit den zukünftigen Fachanwendern eine Prüfmatrix aus 30 bis 50 realen Fragen, deren korrekte Antworten bekannt sind. Messen Sie:
- Wie viele Fragen wurden fachlich korrekt beantwortet?
- Wurde die exakt passende Fundstelle zitiert?
- Hat das System bei unbelegten Fragen zuverlässig verweigert?
Erreicht das System die vorab definierten Akzeptanzkriterien, wird der reguläre Rollout beschlossen. Erfüllt es die Kriterien nicht, wird nachgebessert oder das Vorhaben gestoppt – wodurch teure Fehlallokationen vermieden werden.
Häufig gestellte Fragen (FAQ)
### Welche Dokumentenformate können in einen RAG-Workflow eingebunden werden? Typischerweise verarbeitet die Pipeline PDF-Dokumente, Microsoft-Word-Dateien (.docx), Excel-Tabellen (.xlsx), Text- und Markdown-Dateien sowie HTML-Seiten. Entscheidend ist die Textqualität: Maschinell erstellte Dokumente lassen sich direkt einlesen; bei eingescannten Papierbelegen muss eine qualitativ hochwertige Texterkennung (OCR) vorgeschaltet werden, da unleserliche Scans zu fehlerhaften Suchtreffern führen.
### Können vertrauliche Dokumente über eine RAG-Pipeline versehentlich an Dritte gelangen? Nein, sofern das System nach Enterprise-Standards betrieben wird. Bei Verwendung von dedizierten EU-Cloud-Endpunkten (wie Azure OpenAI mit EU Data Zone) oder lokalen Open-Weights-Modellen verbleiben die Daten vollständig im eigenen Hoheitsbereich und werden von den Anbietern nicht zum Modelltraining verwendet. Innerhalb des Unternehmens verhindert eine strikte Metadaten-Filterung (Pre-Search ACL), dass Mitarbeiter Zugriff auf Dokumente erhalten, für die sie keine Berechtigung besitzen.
### Wie unterscheidet sich ein RAG-Workflow von der herkömmlichen Windows- oder SharePoint-Suche? Klassische Suchmaschinen arbeiten rein stichwortbasiert: Sie finden Dokumente nur, wenn die exakten Suchbegriffe vorkommen. RAG versteht die semantische Bedeutung der Frage auch bei Synonymen oder umschreibenden Formulierungen. Vor allem aber liefert RAG keine bloße Trefferliste von 20 PDFs, sondern formuliert eine direkte, präzise Zusammenfassung der Antwort und verweist punktgenau auf die relevante Textpassage.
### Was passiert, wenn sich ein Dokument im Unternehmen ändert oder gelöscht wird? Eine professionelle RAG-Pipeline beinhaltet inkrementelle Synchronisationsmechanismen: Wird ein Dokument auf dem Fileshare oder im Dokumentenmanagementsystem aktualisiert, werden die alten Chunks aus dem Index entfernt und durch die Neuberechnung ersetzt. Gelöschte Dokumente werden unverzüglich aus dem Vektorindex ausgetragen, sodass das System nicht mehr auf veraltete Bestände zugreift.
Nächste Schritte
Planen Sie die Einführung eines gezielten KI-Piloten in Ihrem Unternehmen und möchten Risiken von Anfang an minimieren?
- Detaillierte Informationen zu maßgeschneiderten RAG-Lösungen und Unternehmens-Assistenten finden Sie unter KI Business Solutions.
- Für eine übergreifende Standortbestimmung Ihrer KI-Readiness und Governance-Strukturen steht der Bereich KI-Transformation bereit.
- Wie KI-Agenten und Werkzeug-Schnittstellen in automatisierte Pipelines eingebunden werden, vertieft der Artikel KI-Agenten und MCP in CI/CD-Pipelines, während AI-Coding Enablement die methodische Absicherung im Entwicklerteam behandelt.
- Quellen (abgerufen am 21.11.2026):
- Statistik Austria, IKT-Einsatz in Unternehmen (aktuelle Erhebung 2026, veröffentlicht am 20.10.2026):
https://www.statistik.at/statistiken/forschung-innovation-digitalisierung/digitale-wirtschaft-und-gesellschaft/ikt-einsatz-in-unternehmen - Statistik Austria, Pressemitteilung vom 24.06.2026 (Bezugsjahr 2025):
https://www.statistik.at/fileadmin/announcement/2026/06/20260624IKTU2025.pdf - Wirtschaftskammer Österreich (WKO), KI-Guidelines für Unternehmen:
https://www.wko.at/ooe/digitalisierung/ki-guidelines/ki-guidelines.pdf - Microsoft Learn, RAG solution design and evaluation guide:
https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/rag/rag-solution-design-and-evaluation-guide - OWASP Top 10 for LLM Applications (2025):
https://owasp.org/www-project-top-10-for-large-language-model-applications/